 电脑恢复下载
 首页
 资讯
服务器RAID数据恢复?缺一块盘的时候别重组
机房那边打电话来,说阵列红灯了,业务还在跑,问要不要马上换盘重建。我说先别动,把业务停了,把盘按顺序编号取下来。重建这事,急不得。
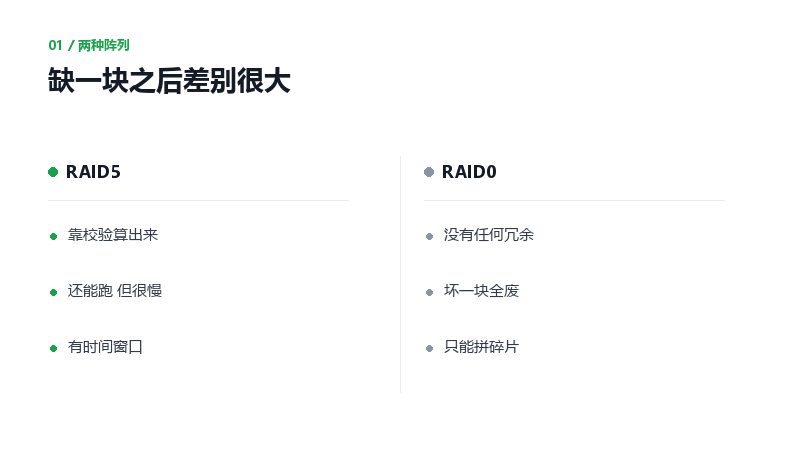
RAID5 和 RAID0 缺盘之后的状态
01缺一块盘阵列还能跑
RAID5 至少三块盘,允许坏一块,靠校验位把缺的数据算出来。这时候系统还在跑,但每读一次都在算,速度掉一半以上。
RAID0 没有校验,坏一块全废,没有任何冗余。RAID1 是镜像,坏一块另一块就是完整副本,最简单。RAID6 允许坏两块,但重建更慢。
所以第一件事是搞清楚阵列级别。不知道级别就动手,等于闭着眼睛修表。
02别在阵列上做重建
重建会把剩下所有盘从头到尾读一遍。这个过程几小时到几十小时,期间任何一块盘读出错,整个阵列就崩了。
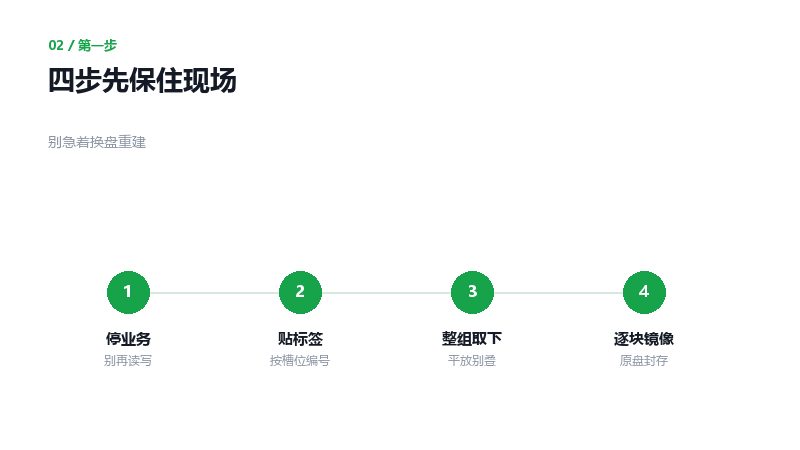
停业务、编号、取盘、离线镜像
老盘尤其危险。同一批采购的盘,用了同样的年头,坏一块之后剩下的往往也到了寿命边缘,重建时再坏一块的概率不低。
03四种阵列的容错
RAID5 的校验分布在各盘上,缺一块可以算出来;RAID6 双校验,缺两块还能撑;RAID10 是镜像加条带,坏的那块直接从镜像读;RAID0 什么保护都没有。
还得看有没有热备盘。有热备的阵列会自动顶上开始重建,这个动作你拦不住,只能尽快把重要数据拷出来。
重建的时候别做别的重活。同一台机器上跑备份、跑报表,都会拖慢重建,时间越长风险越大。
| 阵列级别 | 最少几块盘 | 能坏几块 | 缺盘之后怎么办 |
|---|---|---|---|
| RAID0 | 2 | 一块都不能坏 | 别重建 直接镜像 |
| RAID1 | 2 | 一块 | 换盘 从镜像拷 |
| RAID5 | 3 | 一块 | 先镜像 再谈重建 |
| RAID6 | 4 | 两块 | 同上 时间更紧 |
| RAID10 | 4 | 每组一块 | 从镜像组读 |
表格里说的是理论容错。实际能不能撑住,取决于剩下盘的健康度和阵列卡的状态。
04镜像顺序不能错
取盘之前先编号。按槽位号贴标签,1、2、3 这样,取下来平放,别叠。顺序错了,重组的时候拼出来的是一堆乱码。
每块盘单独做镜像,做成 img 文件,之后所有尝试都在镜像上做。原盘封存,一次都别再通电。
盘数多的时候,镜像要一台专门的机器和足够的存储空间,容量按盘数乘单盘容量算,别到一半发现空间不够。
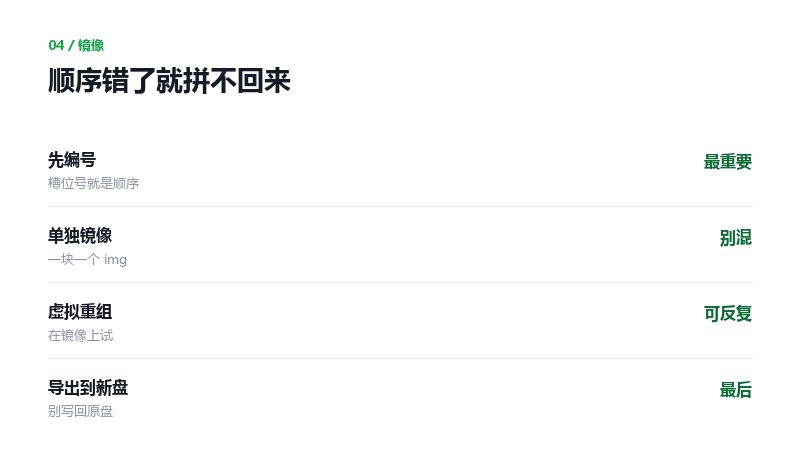
编号、单独镜像、虚拟重组、导出
镜像做完要校验。把每块盘的镜像大小和原盘对一遍,差得多的说明中途读错了,那块盘得单独处理。校验这步很多教程省了,出事就出在这儿。
05什么时候必须进洁净间
阵列里有盘出现异响、认不到、或者镜像读到一半大量报错,这就不是软件层的事了,得开盘。
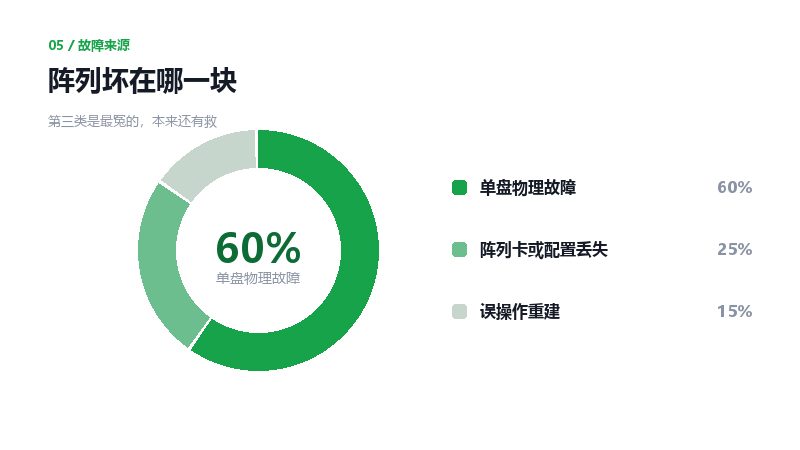
阵列故障的三种来源占比
开盘要在洁净环境里做,换磁头、读盘片,一块盘的费用八百到三千,按容量和难度算。整个阵列几块盘一起出问题,费用会叠加。
06还有两个常被追问的
虚拟机和数据库也能这样恢复吗
能,但多一层。先重组出阵列的逻辑盘,再从逻辑盘里解析文件系统,最后才是虚拟机文件或者数据库文件。层数越多,成功率越低。
云服务器上的阵列坏了怎么办
云上的盘是块存储,底层冗余由服务商负责,你能做的是挂快照。平时开自动快照,比出事之后找恢复便宜得多。
阵列出问题先停业务、记顺序、做镜像。重建是最后一步,不是第一步。顺序记错,神仙也拼不回来。