
 电脑恢复下载
 首页
 资讯
服务器硬盘坏了数据怎么恢复-阵列先别重组
服务器比单块硬盘麻烦,因为数据是拆开分布在几块盘上的。一块坏了,靠校验能算回来;两块坏了,或者重建过程中又坏一块,就容易崩。
崩了之后最要紧的一句话:别点 rebuild,别初始化,别拿新盘顶上去自动同步。
为什么不能随便重建
重建的逻辑是"用剩下的盘和校验数据,把坏盘上的内容算出来写进新盘"。这个过程中,所有盘都要被大量读取,包括那些已经有坏道、勉强能读的盘。
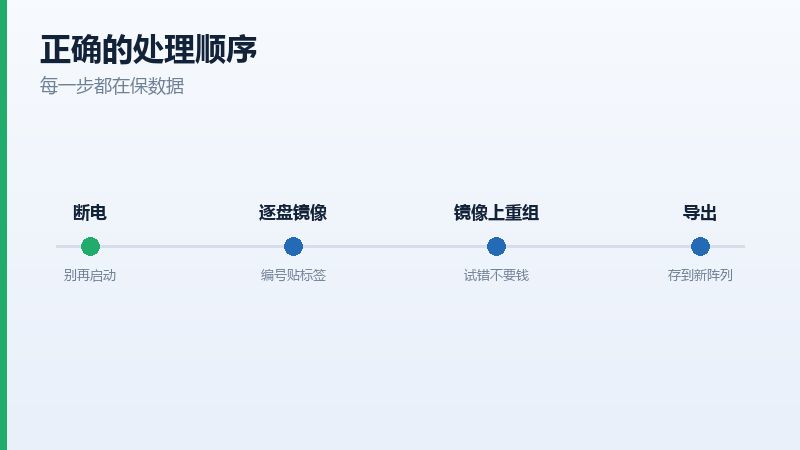
压力一大,第二块盘掉线,阵列就彻底废了。而且重建会往盘上写数据,把原来残留的信息覆盖掉。专业做法是先给每块盘做镜像,再在镜像上试重组。
先判断坏了几块
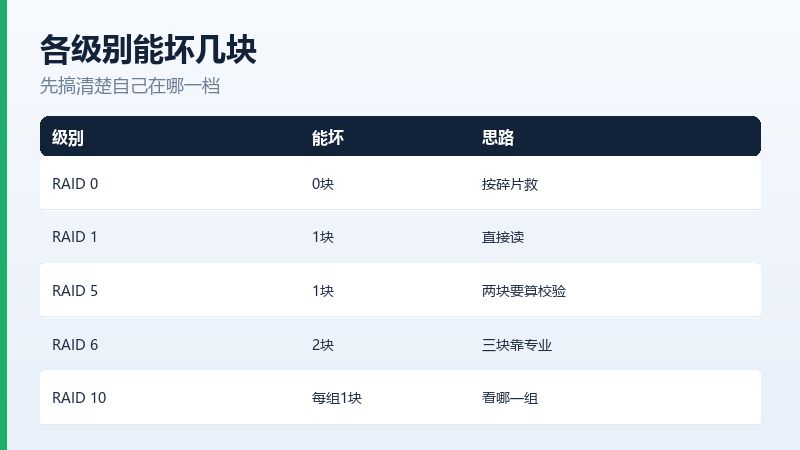
| RAID 级别 | 能坏几块 | 坏了之后的思路 |
|---|---|---|
| RAID 0 | 一块都不能坏 | 条带无校验,只能按文件碎片救 |
| RAID 1 | 可坏一块 | 剩下的盘直接读 |
| RAID 5 | 可坏一块 | 两块坏就要算校验 |
| RAID 6 | 可坏两块 | 三块坏基本要靠专业 |
| RAID 10 | 每组可坏一块 | 看是哪一组坏的 |
镜像的顺序很关键
每块盘单独做镜像,编号贴标签,记清楚哪块盘原来在哪个槽位。这个顺序错了,重组的时候数据全乱。
镜像过程中遇到坏道,设置跳过,先把能读的读完。有异响的盘放最后做,或者直接送专业,别硬读。
镜像做完,所有操作都在镜像文件上做,原盘封存。这样试错成本是零,重组错了可以重来。
重组靠什么
靠阵列的参数:RAID 级别、条带大小、盘的顺序、校验的方向。这几个参数对上,数据就能拼出来。参数不知道的话,专业软件可以自动试,几十种组合一个个跑。
这也是为什么服务器恢复比单盘贵得多——不是技术玄,是工作量大。几块盘的镜像加参数试错,两三天很正常。
什么时候必须找专业
两块以上盘同时坏、盘有异响、阵列卡自己把配置丢了、虚拟机的磁盘文件损坏。这几种自己在家搞,成功率很低。
找专业之前,把服务器的型号、阵列卡型号、几块盘、什么级别的 RAID 记下来,这些信息能省掉对方半天时间。
如果服务器还在保修期内,先打厂商电话。有些厂商提供付费的数据恢复服务,价格透明,也不用担心盘在别人手里出问题。
还有一条:恢复出来的数据别写回原阵列。换一套新盘,重建阵列,再把数据导进去。原阵列留着,万一导的过程出问题还能再来一次。
恢复之后要不要换设备
要。已经出过一次故障的阵列,说明其中至少一块盘到了寿命末期。数据拿出来之后,整组换新盘,别在原阵列上继续用。
换的时候顺便把级别调一下。原来是 RAID 5 的,可以考虑 RAID 6 或者 RAID 10,代价是多一块盘的空间,换来的是再坏一块也不至于全崩。
还有一件事比换盘更重要:把备份做起来。阵列不是备份,它只是让单块盘坏掉的时候业务不停。误删、加密、机房进水,阵列一样救不了。
两个问题
单块盘坏的阵列,能不能自己换盘
能,但有前提:确认是单盘故障,而且剩下盘都健康。换盘之前先做一次全盘校验,看有没有隐藏的坏道。有坏道就先备份,别急着重建。
云服务器还需要考虑这些吗
云上的盘由服务商保证冗余,但误删、被加密、快照被覆盖这些事还是会发生。云上的恢复主要靠快照和备份策略,出事第一件事是停止写入并回滚快照。