 电脑恢复下载
 首页
 资讯
服务器RAID数据恢复?先别重组阵列
一台四盘位的服务器,亮了两个黄灯。管理员的第一反应是把坏盘拔了换新的,再让阵列自己重建。这个动作,把本来能救的数据写没了。
01重建是最危险的动作
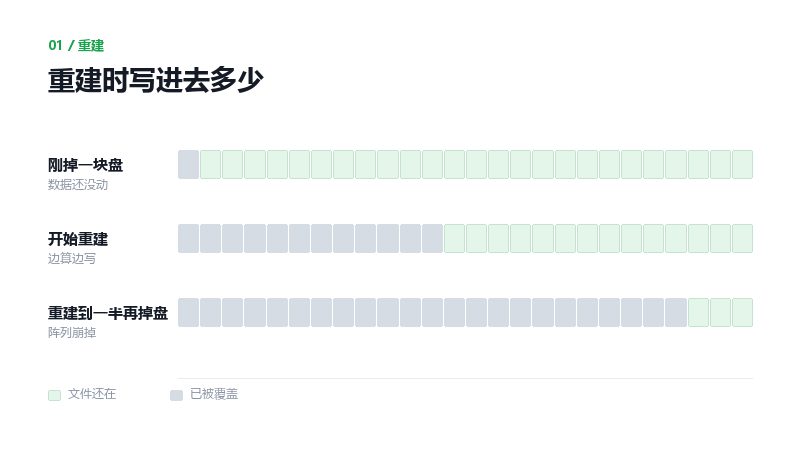
重建过程中数据区被重写的比例
RAID5 允许坏一块盘。系统检测到坏盘,会用剩下盘的校验数据算出缺失的部分,重新写回新盘。
这个计算过程要读所有盘。剩下的盘如果也有隐患,重建时的高强度读取会把它压垮,第二块盘跟着掉线。
两块盘一掉,RAID5 就彻底崩了。校验数据能补一块,补不了两块。
更麻烦的是重建会往新盘里写。写进去的是算出来的数据,一旦算错,原来的东西就对不上了。重建一次,等于把现场改一遍。
02先确认是几号盘坏
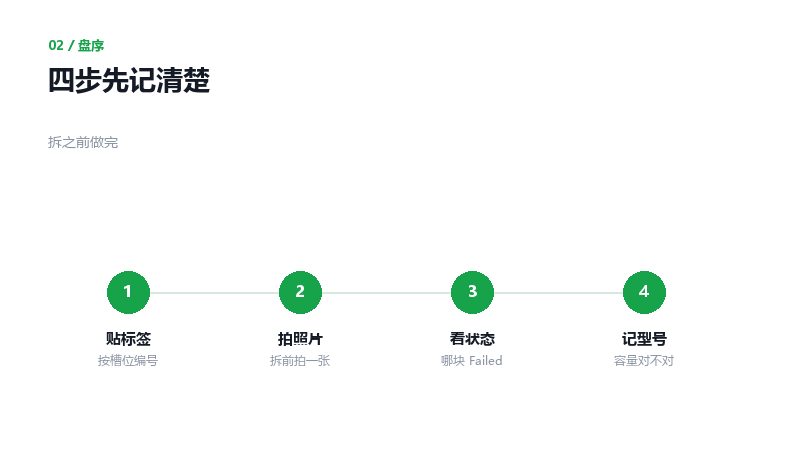
确认盘序的四个步骤
把盘按槽位编号。0 到 3 或者 1 到 4,用标签贴在盘上,拆下来之前先拍照。
进阵列卡的管理界面看状态。哪块是 Online,哪块是 Failed,哪块是 Rebuild,记下来。
再看盘的型号和容量。混插过不同容量的阵列,重建顺序会更复杂,有的甚至不是标准 RAID,得靠工具反推。 老服务器还要看电池。阵列卡的缓存电池没电,写入策略会变,盘上的数据可能有一段时间没落盘。
这四步做完再动手拆。盘序错了,后面所有努力都白费,这是阵列恢复里最容易犯的错。
03RAID5缺一块和缺两块
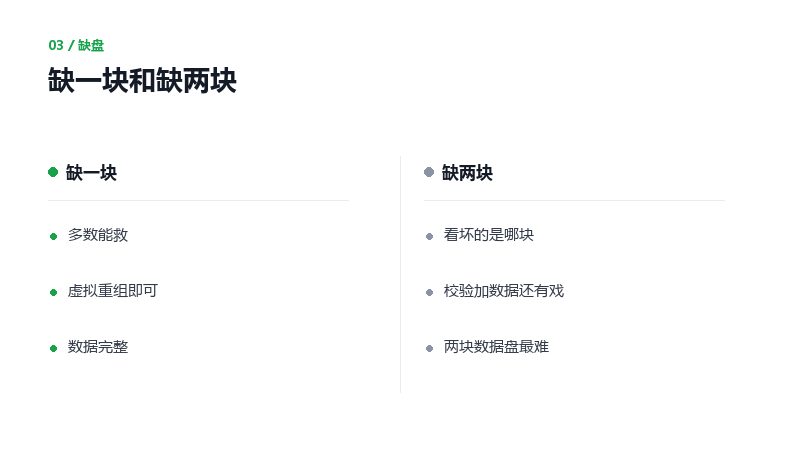
缺一块和缺两块的两种结局
缺一块,多数情况能救。把好盘全部做镜像,用软件虚拟重组,能读出完整数据。
缺两块,看坏的是哪两块。如果是校验盘加数据盘,还有机会;两块都是数据盘,就得按文件结构一点点拼。
RAID0 最惨。它是条带,没有校验,坏一块全部完蛋,只能从剩下的盘里捞零散文件。
RAID1 和 RAID10 相对好办,镜像关系,一块盘的数据就是全部数据,直接读就行。
04为什么不建议自己换盘
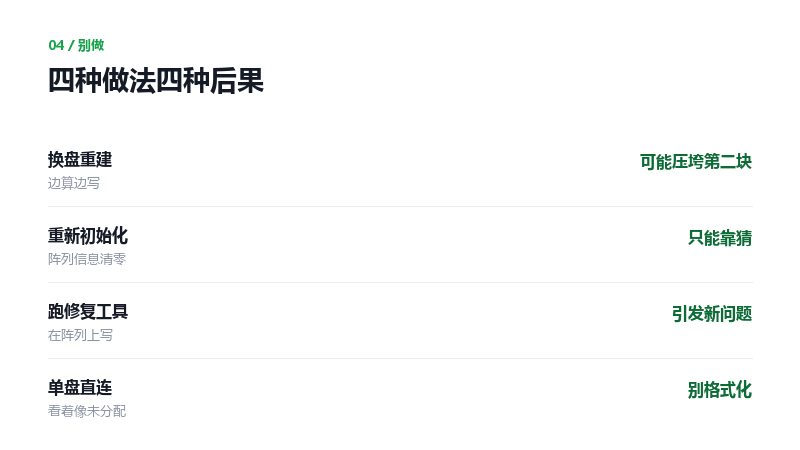
四种做法和各自的后果
换盘重建,是最常见的错误。前面说了,重建会写盘,还可能压垮第二块盘。
重新初始化阵列,等于把阵列信息全清掉。清完再想按原结构读,得靠软件猜,成功率掉一半。
用系统自带的修复工具,比如 chkdsk,会在阵列上写。阵列本身就不稳,写入可能引发新的问题。
还有一种,把盘单独接到电脑上看。单块盘在 RAID5 里只是一片碎片,看着像未分配,有人就顺手格式化了。
05送修要带什么
所有盘,包括已经确认坏的那块。坏盘里也可能有可读的部分,别扔。
阵列卡型号和配置信息。RAID 级别、条带大小、盘序,这三样决定能不能重组。
服务器型号和系统信息。有的阵列把配置存在盘上,有的存在卡上,处理方式不一样。
还有业务上的信息:哪个文件夹最重要,哪个库不能少。有优先级,恢复的顺序就能排。 数据库类的还要带配置文件。SQL 的 mdf 和 ldf、MySQL 的 ibd,缺了日志文件,库可能挂不上。
06两个关于阵列的疑问
亮黄灯还能继续用吗
能读就先读,把重要数据拷出来。别在这个状态下跑重建,也别继续写入新数据。
虚拟机能单独恢复吗
能。虚拟机的磁盘文件是大文件,从阵列里捞出来之后,用虚拟化软件挂载就能读到里面的系统。
阵列坏盘先别换、别重建。按原顺序做镜像,在镜像上虚拟重组,顺序错一位数据就散了。