 电脑恢复下载
 首页
 资讯
PDF文件损坏打不开怎么修复_三种坏法分开试
合同、发票、扫描件,现在多是 PDF。打不开的时候提示五花八门:文件已损坏、格式错误、需要密码。这三种提示背后是三件不同的事,处理方式也完全不同。
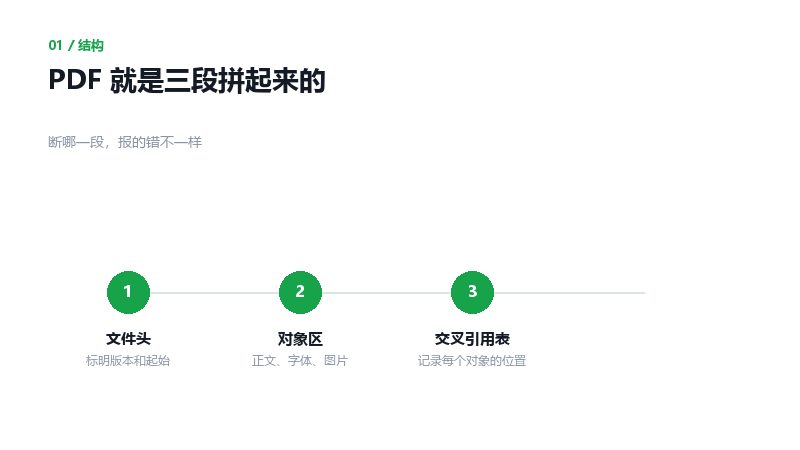
PDF 的三段结构和对应的坏法
01先看提示原文
PDF 的结构分三段:文件头、对象区、交叉引用表,最后一行是结束标记。任何一段断了,阅读器都会报错,但报的错不一样。
提示「文件已损坏,无法修复」,多半是尾部缺失,文件没传完、下载中断、U 盘没拔就拔了。
提示「格式错误」,是文件头或者对象区被改过,比如用记事本打开又保存了一次,编码变了,字节也变了。
提示「需要密码」,那不是坏,是加密。这是另一条路,输密码或者解密就行。
02文件尾缺失最常见
尾巴缺失最好修。找一份正常的 PDF,把它的尾部结构接到坏文件后面,多数阅读器就能打开,内容能看到,只是最后几页可能不全。
接的时候要注意对象编号连续。编号断了,阅读器会认为文件不完整,这时候用 qpdf 的重建功能扫一遍,它会从头解析对象,重新生成交叉引用表。
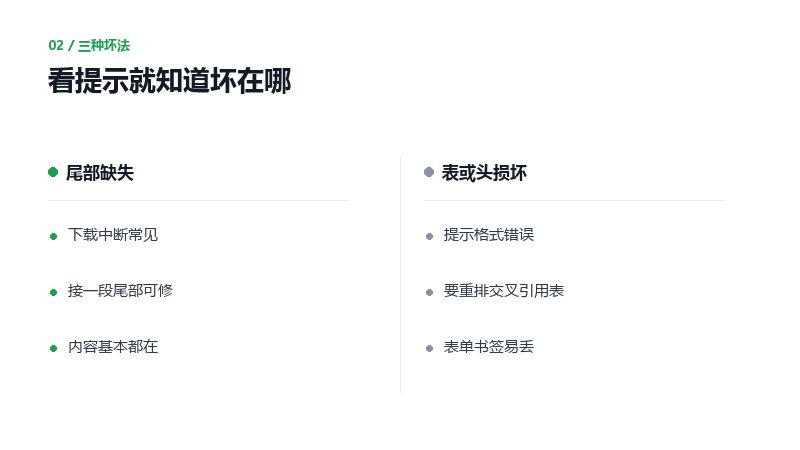
三种坏法的判断和处理
重建的命令是 qpdf 加 --replace-input 参数,跑完输出一份新文件,原文件不动。这一步对多数尾部损坏的 PDF 有效。
03交叉引用表坏了
交叉引用表记录每个对象在文件里的字节位置。表坏了,阅读器找不到内容,表现是一打开就空白,或者只显示第一页。
处理办法是忽略原表,从头扫对象。qpdf 加 --qdf 参数能重排结构,Ghostscript 的 pdfwrite 能重新画一遍,输出一份全新的 PDF。
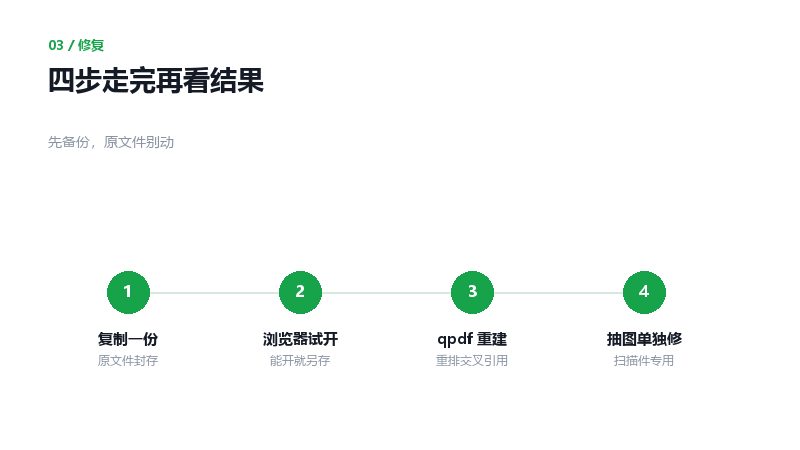
修复 PDF 的四个步骤
重画会丢掉一部分交互元素:表单域、书签、链接。如果这些重要,优先用 qpdf 重排,别用重画。
04扫描件还有一层
扫描件是图片套在 PDF 里,坏法多一层:外层结构是好的,里面那张 JPEG 坏了。这时候打开能看到页面框架,但画面是空白或者灰色的。
把 PDF 里的图片抽出来单独修。pdfimages 这个命令行工具能把每页的图导出来,导出来是 jpg 或者 jp2 格式。
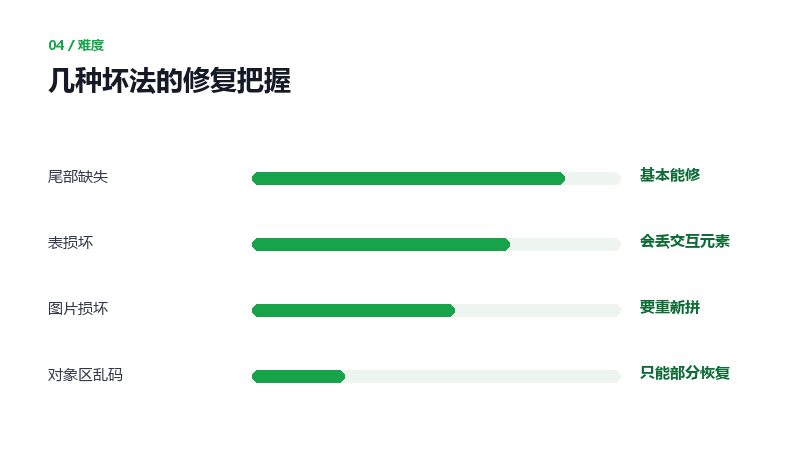
几种坏法的修复把握差很多
抽图之前先看页数对不对。页数少了几页,说明对象区缺了,抽出来的图也只是剩下的那些。
图片修好之后,用图片重新生成 PDF。原来那层文字(如果有 OCR)会丢,需要重新识别一遍。
05浏览器能打开就先另存
Chrome 和 Edge 的内核比很多桌面阅读器宽容。坏得不严重的时候,浏览器能正常翻页,桌面阅读器却报错。
能显示就赶紧打印成新 PDF,选「另存为 PDF」这个虚拟打印机。输出的文件结构是全新的,坏的地方被跳过。
这是最省事的抢救办法,一分钟能做完。缺点是丢掉的页面补不回来,只能看到多少存多少。
06还有两个常被追问的
加密的PDF算损坏吗
不算。有打开密码的,输入密码就能看;有权限密码的(不能打印、不能复制),用qpdf解密一下就能编辑,这种密码是防君子不防小人。
修完字变糊了是怎么回事
那是原图分辨率不够,不是修复造成的。修复只能恢复已有的像素,不能凭空提高清晰度。想清楚只能重新扫描。
PDF 坏先看提示:尾部缺了接一段,表坏了重排一遍,图片坏了抽出来修。浏览器能打开就立刻另存一份。